Eerst het plan, dan de code
In dit artikel:
- Het eerste plan was eigenlijk best goed
- Plan Mode is voor mij een reviewproces
- Een goede oplossing op de verkeerde plek
- Systeemgrenzen bestaan ook buiten de code
- Niet vragen om uitleg, maar het plan compleet maken
- De implementatie is niet het moment waarop ik dit wil ontdekken
- Het vakmanschap schuift naar voren
Een van de veranderingen in mijn manier van werken met coding agents is dat ik steeds minder tijd kwijt ben aan het daadwerkelijk schrijven van code. Dat betekent niet dat een grotere wijziging ineens weinig tijd kost. Die tijd is vooral naar voren geschoven.
Bij een recente wijziging moest ik uitzoeken waarom gebruikers na een succesvolle betaling soms lang moesten wachten voordat hun bestelling werd verwerkt. De betaling liep via een externe payment provider. Na het betalen werd de gebruiker via de browser teruggestuurd naar onze applicatie, waarna de verwerking verderging. Als de gebruiker die browserflow afbrak, kreeg onze applicatie die bevestiging niet. Een background job ruimde dat uiteindelijk op, maar daardoor kon iemand in het slechtste geval ongeveer een half uur wachten terwijl het geld al was afgeschreven.
Mijn opdracht aan de agent was bewust nog niet om dit op te lossen. Ik wilde eerst onderzoeken welke mogelijkheden er waren om de bevestiging betrouwbaarder en sneller te maken.
Een paar minuten later lag er al een behoorlijk concreet plan. Gebruik een webhook van de payment provider als primaire bevestiging, behandel de bestaande return-URL vooral als onderdeel van de gebruikerservaring, hergebruik de bestaande completion flow en laat de background job vaker draaien als vangnet. De bestaande guards in de applicatie zouden ervoor zorgen dat die verschillende routes elkaar niet in de weg zaten.
Als ik op dat moment opdracht had gegeven om het plan uit te voeren, was er waarschijnlijk vrij snel werkende code uitgekomen.
In plaats daarvan heb ik er een groot deel van de middag over doorgepraat.
Een plan hoeft niet fout te zijn om nog niet goed genoeg te zijn.


Het eerste plan was eigenlijk best goed
Dat vind ik belangrijk om erbij te zeggen. Het probleem met het eerste voorstel was niet dat de agent onzin produceerde. Integendeel. De oplossing was technisch aannemelijk, sloot aan op de bestaande applicatie en ging op hoofdlijnen de goede kant op.
Maar een aannemelijke oplossing is nog geen ontwerp waar ik verantwoordelijkheid voor wil nemen.
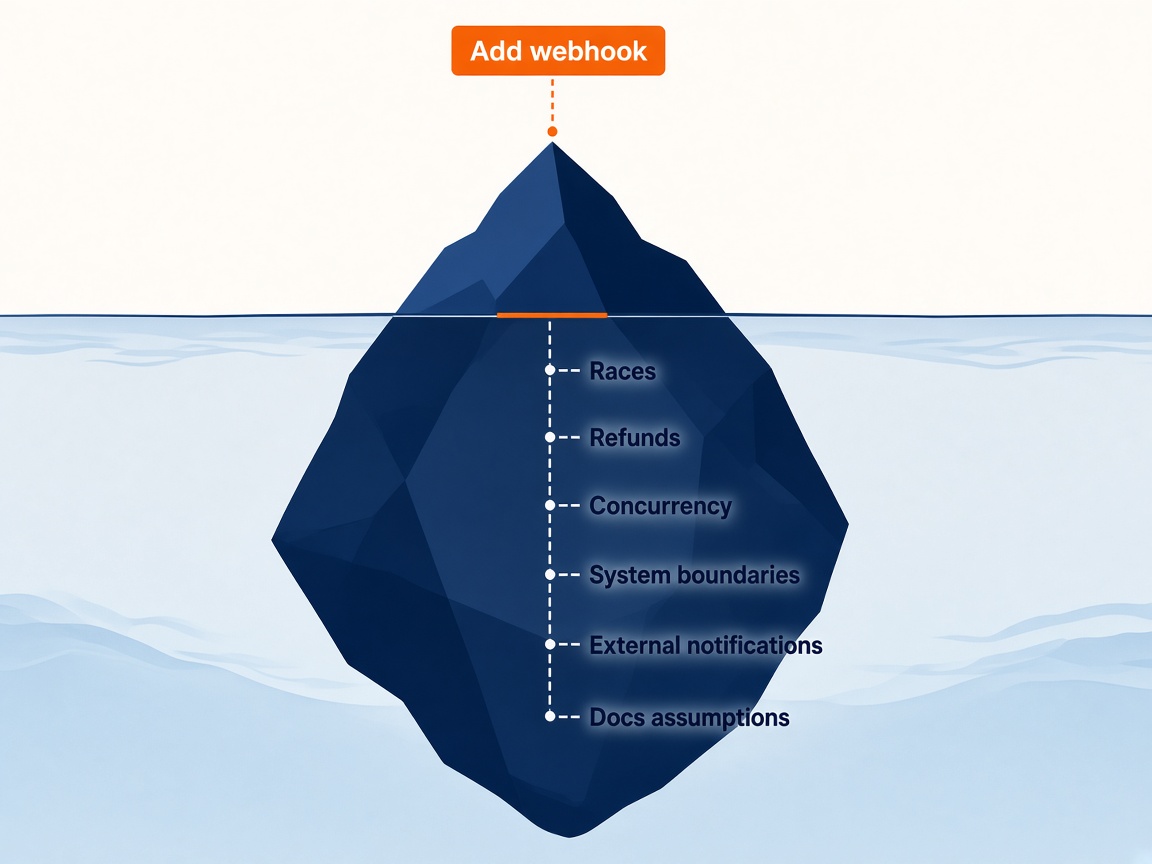
Het plan introduceerde bijvoorbeeld een webhook naast de bestaande return-URL. Dat is logisch: de return-URL is afhankelijk van de browser van de gebruiker, terwijl een webhook server-to-server binnenkomt. Ik wilde vooral dat het plan de consequenties van die keuze meenam.
Zodra beide routes een betaling kunnen verwerken, heb je twee onafhankelijke processen die ongeveer tegelijkertijd hetzelfde kunnen proberen te doen. En eigenlijk waren het er drie, want de background job bestond ook nog.
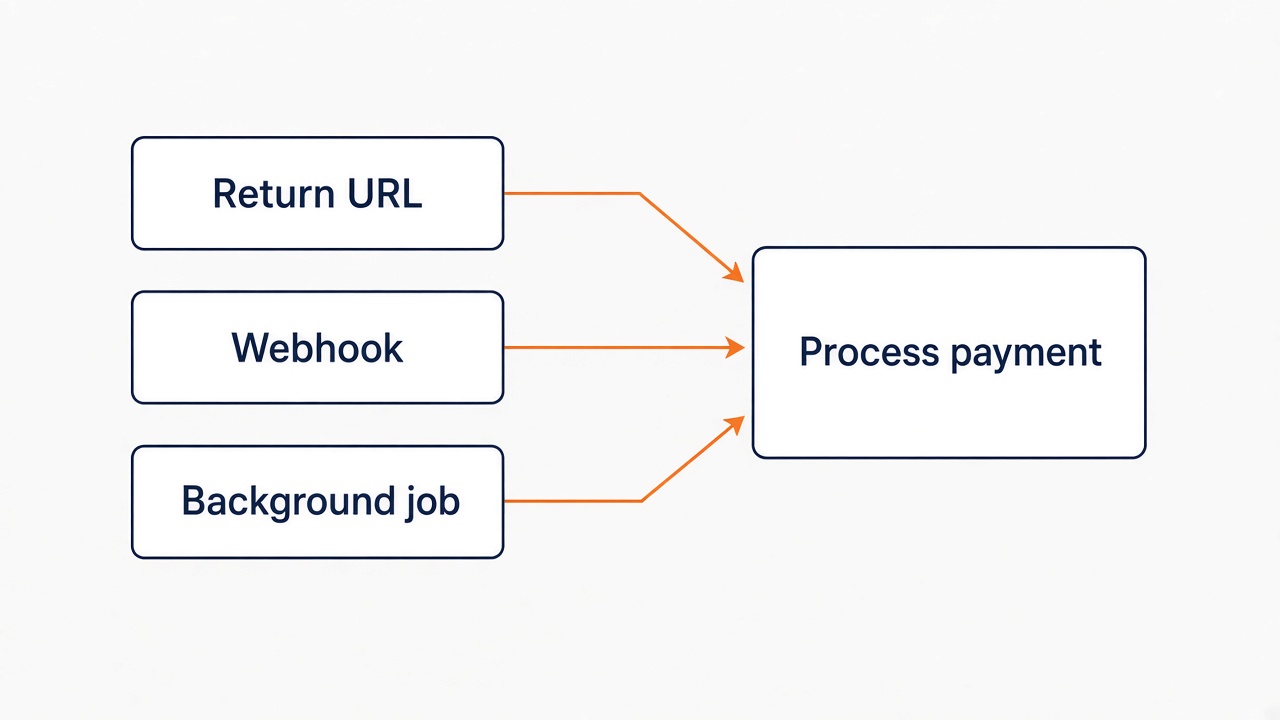
Het eerste plan ging ervan uit dat de bestaande guards voldoende bescherming boden tegen dubbele verwerking. Daar heb ik de agent op teruggestuurd. Verschillende processen konden dezelfde betaling verwerken, dus wat gebeurde er wanneer twee daarvan vrijwel tegelijkertijd dezelfde status lazen?
Bij het nalopen van de bestaande code bleek die race inderdaad mogelijk. Twee processen konden allebei constateren dat de betaling nog verwerkt moest worden en vervolgens allebei doorgaan.
De ontwerpvraag was daarmee veranderd. We zochten niet meer alleen naar een snellere manier om een betalingsbevestiging binnen te krijgen. We moesten bepalen hoe meerdere onafhankelijke processen veilig dezelfde betaling konden verwerken.
Plan Mode is voor mij een reviewproces
Ik gebruik Plan Mode niet als een plek waar ik een uitgebreide prompt schrijf, een architectuur terugkrijg en vervolgens op Build druk. Het is eerder een ontwerp-review.
De agent doet een voorstel. Ik probeer vervolgens de aannames in dat voorstel boven water te krijgen. Ik stel vragen over keuzes en consequenties, laat relevante code verder onderzoeken en vraag om alternatieven wanneer een keuze mij niet overtuigt. Als externe systemen onderdeel van de wijziging zijn, pakken we ook de documentatie erbij.
Het plan verandert ondertussen mee.
De agent hoeft niet met een slecht voorstel te komen om mijn input nodig te hebben. Juist een aannemelijk voorstel moet worden getoetst aan de dingen die nog niet zijn meegenomen.
Dat gebeurde bijvoorbeeld bij de status van een succesvolle betaling. Een van de voorstellen was om Succeeded feitelijk als definitieve status te behandelen.
Dat loste de race condition alleen niet op. Twee processen konden nog steeds allebei de oude status lezen voordat een van beide Succeeded had geschreven. Bovendien wees ik erop dat een betaling na Succeeded nog kan veranderen. Een refund is ook een geldige latere statuswijziging. We zouden dus een race niet oplossen en tegelijkertijd een bestaande flow blokkeren.
Het voorstel was begrijpelijk, maar mijn input was nodig om het tegen de volledige levenscyclus van een betaling te houden.
Een goede oplossing op de verkeerde plek
Toen duidelijk werd dat de race op een andere manier opgelost moest worden, kwam de agent met locking. Ook dat was op zichzelf een logisch voorstel.
Ik wees er alleen op dat dezelfde betalingsgegevens vanuit verschillende processen werden verwerkt. Een in-memory lock beschermt één proces tegen gelijktijdige verwerking binnen datzelfde proces. Een ander proces weet niets van die lock en kan ondertussen dezelfde betaling laden.
De concurrencybescherming moest dus plaatsvinden op een niveau dat door alle betrokken processen werd gedeeld, bijvoorbeeld via optimistic concurrency op de opslag.
Daar kwam nog een complicatie bij. Een succesvolle verwerking betekende niet alleen dat onze eigen database werd bijgewerkt. Er moest ook een extern back-endsysteem worden aangeroepen, en ook die aanroep mocht maar één keer plaatsvinden.
Het was dus niet voldoende om alleen het schrijven van de lokale status te beschermen. Ook het recht om de externe verwerking uit te voeren moest onderdeel zijn van dezelfde concurrency- en idempotency-oplossing.
Daaruit volgde meteen een volgende ontwerpvraag: wat gebeurt er wanneer een proces de betaling claimt, maar de update naar het externe systeem vervolgens mislukt? Wanneer mag een ander proces het opnieuw proberen? Hoe voorkomen we zowel dubbele verwerking als een betaling die na een tijdelijke fout nooit meer wordt opgepakt?
Dat soort vragen veranderde het plan stap voor stap. Een lokaal goede oplossing moest telkens worden getoetst aan de rest van de flow.
Systeemgrenzen bestaan ook buiten de code
Een vergelijkbaar moment ontstond bij de plaats waar de webhook moest binnenkomen.
De agent redeneerde vanuit de bestaande payment-logica en stelde voor de webhook daar te verwerken. Technisch gezien een voor de hand liggende plek: daar stond tenslotte de code die wist hoe betalingen verwerkt moesten worden.
Alleen was die service intern. De externe payment provider kon hem helemaal niet bereiken.
Menselijke kennis van hoe de applicatie daadwerkelijk was gedeployed en bereikbaar was, maakte duidelijk waarom het voorstel niet rechtstreeks kon werken. De webhook moest binnenkomen op een publiek bereikbaar onderdeel van het systeem en van daaruit gecontroleerd de interne payment-flow bereiken.
Tijdens dezelfde planfase hebben we ook de documentatie van de payment provider erbij gepakt. Welke events worden daadwerkelijk verstuurd? Welke status past bij onze flow? Hoe wordt een bericht ondertekend? Hoe werken retries? Wat gebeurt er wanneer onze applicatie tijdelijk niet bereikbaar is? Welke aannames maken we over de gebruikte API-versie?
Niet iedere vraag veranderde het ontwerp. Sommige bevestigden juist dat een voorstel van de agent prima was. Maar dan was het een gecontroleerde keuze geworden in plaats van een impliciete aanname.
Niet vragen om uitleg, maar het plan compleet maken
De vragen die ik in zo'n sessie stel, zijn dus niet bedoeld om mij de techniek uit te laten leggen. Ik gebruik ze om het plan compleet te krijgen en voorstellen te toetsen aan informatie die de agent nog niet heeft meegenomen.
Soms komt die informatie uit verder onderzoek in de code of documentatie. Soms geef ik zelf de benodigde extra input voor het ontwerp.
De agent kan ondertussen snel alternatieven uitwerken, door de code zoeken en de gevolgen van een keuze verder onderzoeken. Dat maakt zo'n gesprek voor mij juist waardevol. Ik hoef niet ieder alternatief zelf volledig uit te werken om het te kunnen beoordelen.
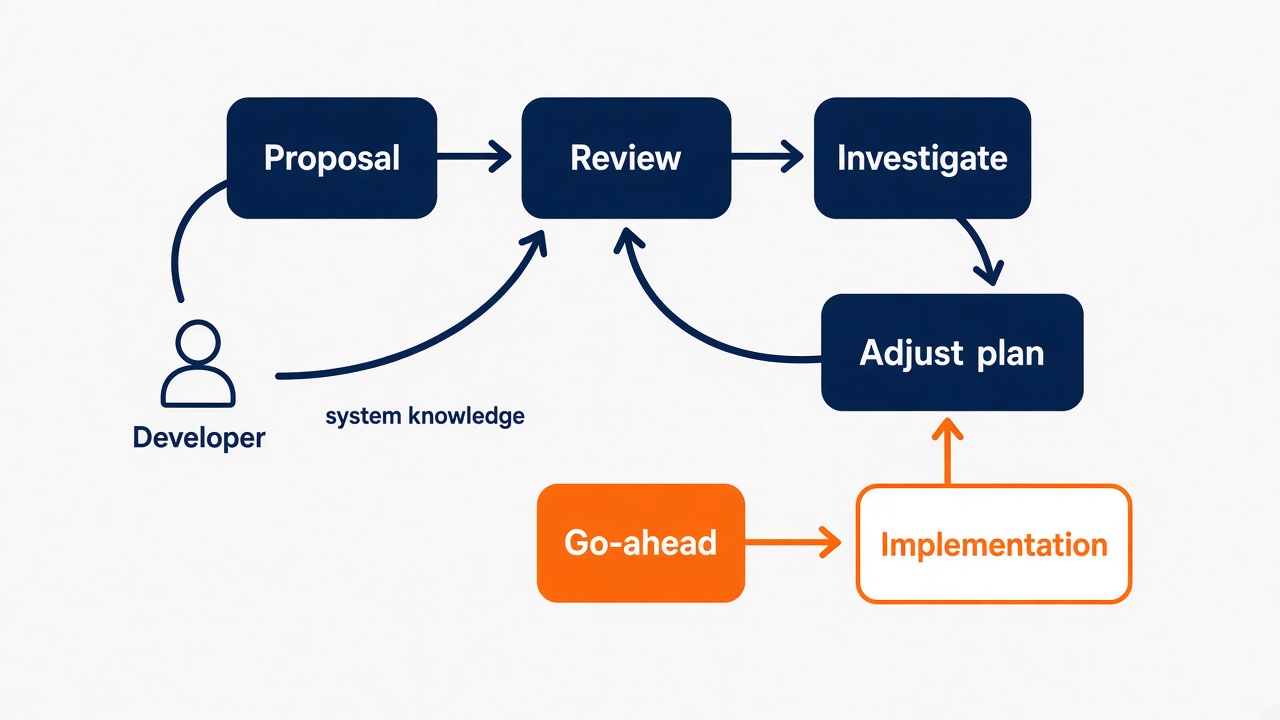
Ik gebruik Plan Mode niet alleen om te zien wat een agent wil bouwen. Ik gebruik het om zijn voorstellen te combineren met de kennis en afwegingen waarvoor ik als developer verantwoordelijk blijf.
De implementatie is niet het moment waarop ik dit wil ontdekken
Bij traditioneel ontwikkelen lopen ontwerp en implementatie vaak meer door elkaar. Je begint aan een oplossing, ontdekt tijdens het programmeren dat een aanname niet klopt, verandert het ontwerp en gaat verder. Het schrijven van code is daarmee voor een deel ook een manier om over het probleem na te denken.
Een coding agent haalt een deel van die natuurlijke weerstand weg. Als ik een plausibel plan goedkeur, kan een agent in korte tijd door een groot deel van de implementatie heen gaan. Dat is precies waar ik hem voor wil gebruiken, maar ik krijg daardoor minder automatisch de tijd die ik tijdens het programmeren had om een ontwerp verder te doorgronden.
Ik probeer die tijd daarom bewust naar voren te halen.
Bij een grotere wijziging lees ik een plan soms meerdere keren. Als de discussie lang is geworden, laat ik het plan samenvatten en lees ik de nieuwe versie opnieuw. Ik gebruik regelmatig een simpele antwoordmodus om te voorkomen dat iedere ontwerpvraag resulteert in pagina's tekst. Zo blijft het gesprek iteratief zonder dat ik de hoofdlijn kwijtraak.
Mijn criterium voor een go-ahead is niet dat het plan perfect is. Ik wil begrijpen wat er gebouwd gaat worden en waarom, welke delen van het systeem geraakt worden, welke belangrijke trade-offs zijn gemaakt en welke risico's we bewust accepteren. Er mogen onzekerheden overblijven, zolang ze maar bewust in het plan staan in plaats van er onzichtbaar onder te liggen.
Het vakmanschap schuift naar voren
Bij deze wijziging kostte het maken en doorgronden van het plan uiteindelijk een groot deel van een middag. De implementatie daarna ging relatief snel.
Dat is een verhouding waar ik door coding agents steeds vaker op uitkom. De productie van code wordt goedkoper en sneller, maar een verkeerde ontwerpbeslissing niet. Een agent kan een verkeerd begrepen ontwerp juist heel efficiënt door een groot deel van de codebase heen implementeren.
Daarom vind ik de tijd vóór de implementatie steeds belangrijker. Niet omdat alles vooraf dichtgetimmerd moet worden, maar omdat dit het moment is waarop ik nog goedkoop vragen kan stellen, alternatieven kan onderzoeken en voorstellen kan afwijzen of aanpassen.
Dat was geen vertraging voordat het echte werk kon beginnen. Dat was een belangrijk deel van het werk.
Dat is voor mij het wezenlijke verschil met vibe coding. Niet dat de agent minder code schrijft. Na mijn go-ahead mag hij juist veel code schrijven. Het verschil is dat ik vóór die go-ahead wil begrijpen welke oplossing ik laat bouwen, welke afwegingen daarin zitten en waar menselijke kennis nodig was om het voorstel compleet te krijgen.
Een goedgekeurd plan is alleen nog geen goede implementatie. Bij een grotere wijziging kan zo'n plan tientallen bestanden en verschillende verantwoordelijkheden beslaan. Geef ik dat in één keer aan één agent, dan verwacht ik nogal veel: dat hij gedurende een lange implementatie de context vasthoudt, verantwoordelijkheden niet door elkaar haalt en overal dezelfde kwaliteit blijft leveren.
Daarom verandert mijn werkwijze na de go-ahead opnieuw. In plaats van één agent het volledige plan te laten uitvoeren, deel ik de implementatie op in afgebakende stukken met ieder een eigen verantwoordelijkheid. Waar het kan, kunnen agents daar zelfs parallel aan werken.
In het volgende artikel gaat het over die stap: hoe ik een goedgekeurd plan omzet in kleine, gerichte implementatie-opdrachten, zodat agents zo zelfstandig mogelijk kunnen werken zonder dat de kwaliteit van de uitvoering verwatert.